|
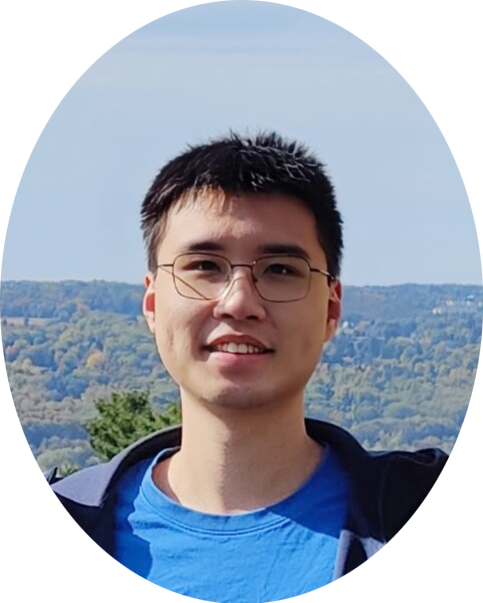
Hi, I'm Runzhe Wu. I received my Ph.D. in Computer Science from Cornell University, where I was advised by Wen Sun. My research focuses on reinforcement learning, particularly its core theories and its interplay with generative models such as language models and diffusion models. I spent the first three years of my Ph.D. at Cornell’s Ithaca campus before moving to Cornell Tech in New York City. Prior to that, I obtained my bachelor's degree in Computer Science from the ACM Honors Class at Shanghai Jiao Tong University, where I conducted research at the APEX Lab under Weinan Zhang and Yong Yu. CV / Google Scholar / X (Twitter) / LinkedIn |
|
|
|
|
Runzhe Wu, Ankur Samanta, Ayush Jain, Scott Fujimoto, Jeongyeol Kwon, Ben Kretzu, Youliang Yu, Kaveh Hassani, Boris Vidolov, Yonathan Efroni EACL, 2026 (Findings) |
|
Ankur Samanta, Akshayaa Magesh, Youliang Yu, Runzhe Wu, Ayush Jain, Daniel Jiang, Boris Vidolov, Paul Sajda, Yonathan Efroni, Kaveh Hassani Preprint, 2025 |
|
Runzhe Wu*, Ayush Sekhari*, Akshay Krishnamurthy, Wen Sun ICLR, 2025 (Oral — top 1.8%) [Talk at RL Theory Seminars] |
|
Runzhe Wu, Yiding Chen, Gokul Swamy, Kianté Brantley, Wen Sun ICLR, 2025 [Code] |
|
Runzhe Wu, Wen Sun ICLR, 2024 |
|
(Alphabetical order) Ayush Sekhari, Karthik Sridharan, Wen Sun, Runzhe Wu NeurIPS, 2023 (Also at the ILHF & MFPL Workshops @ ICML, 2023) [Code] |
|
(Alphabetical order) Ayush Sekhari, Karthik Sridharan, Wen Sun, Runzhe Wu NeurIPS, 2023 (Also at the ILHF Workshop @ ICML, 2023) |
|
Kaiwen Wang, Kevin Zhou, Runzhe Wu, Nathan Kallus, Wen Sun NeurIPS, 2023 [Code] |
|
Runzhe Wu, Masatoshi Uehara, Wen Sun ICML, 2023 [Code] |
|
Ming Zhou, Ziyu Wan, Hanjing Wang, Muning Wen, Runzhe Wu, Ying Wen, Yaodong Yang, Weinan Zhang, Jun Wang JMLR, 2023 [Website] [Code] |
|
Runzhe Wu, Yufeng Zhang, Zhuoran Yang, Zhaoran Wang NeurIPS, 2021 |
|
|
|
@ ICLR 2025, Oral Presentation (Apr 26, 2025) [Slides] [Recording (1:12:00-1:25:00)] @ RL Theory Seminars (Nov 19, 2024) [Slides] [Recording] |
|
|
Before my Ph.D., I competed in programming contests and received the following awards.
|
|
|
|
|
Research Scientist Intern Worked on RL post-training of language models, with an emphasis on multi-task learning. May. 2025 - Aug. 2025 |
|
|
|
|
Ph.D. in Computer Science Ithaca campus (Aug. 2022 – May 2025); Cornell Tech (May 2025 – May 2026) Aug. 2022 – May 2026 |
|
B.Eng. in Computer Science Sep. 2018 - Jun. 2022 |
|
Website template from here. |